對話紀錄
它先說 100%,再更正那句話不存在
-
 Jason使用者本人
-
 BorderAI 助理
-
 Irene影片製作 AI
這是 Jason、Border(AI 助理)與 Irene(影片製作 AI)三方的真實對話濃縮,內容為教師節影片的製作過程紀錄。
0110:48–10:58
先把最難的做完,才派出工單
他丟來歌詞和一首自己用 Suno 做的歌。我沒直接派工 —— 先用本機 whisper 把 204 秒切成逐句時間表,因為對拍是全案最容易翻車的地方。回報完,我又推翻自己一次:不是 100%。
「這是我用 Suno 自己製作出來的音樂。」
Jason · 11:01
「更正:真正的字元相同率是 89.1%。」
Border · 10:58
0211:05
那句話不存在,是聽出來的幻覺
他說想把結尾的「感謝觀看」改成給老師的祝福。我卻回報:音檔裡根本沒有這句話 —— whisper 聽錯了。三項證據:尾段頻譜重心只有 350–390 Hz、頻譜圖沒有語音共振峰、「感」字信心只有 0.03。
「感謝觀看可以改成祝所有老師教師節快樂。」
Jason · 11:01
「音檔裡沒有那句話,那是 whisper 的幻覺。」
Border · 11:05
0311:26–12:27
Irene 那邊,第一個回報的不是「做完了」
派工後她 10:55 開工、12:26 交件,中間跑了兩趟全曲渲染、五趟試片。她先報的是自己找到的 bug:底線動畫的選擇器寫成 #c04u,元素 id 是 c04-u,14 條底線從頭到尾沒動過。
「選擇器寫成 #c04u,id 是 c04-u —— 14 條底線從沒動過。」
Irene · 12:01
「我的獨立驗收:1920×1080、30fps、204.000 秒全部對上。」
Border · 12:28
0416:02–17:31
你回報八個缺陷,我的抽樣驗收漏了整段
你看完成品列出八個時間點。我查下來不是「沒字幕」,是字幕跑在歌聲前面 —— 重複出現的句子永遠查到第一次的時間,第二、三段副歌整段提前。錯在我的驗收方法:抽 6–12 格目視,剛好都落在正常的地方。
「開頭:字壓在人物的身上,需將字下移至下方。」
Jason · 16:02
「我的驗收漏掉了這個。」
Border · 16:11
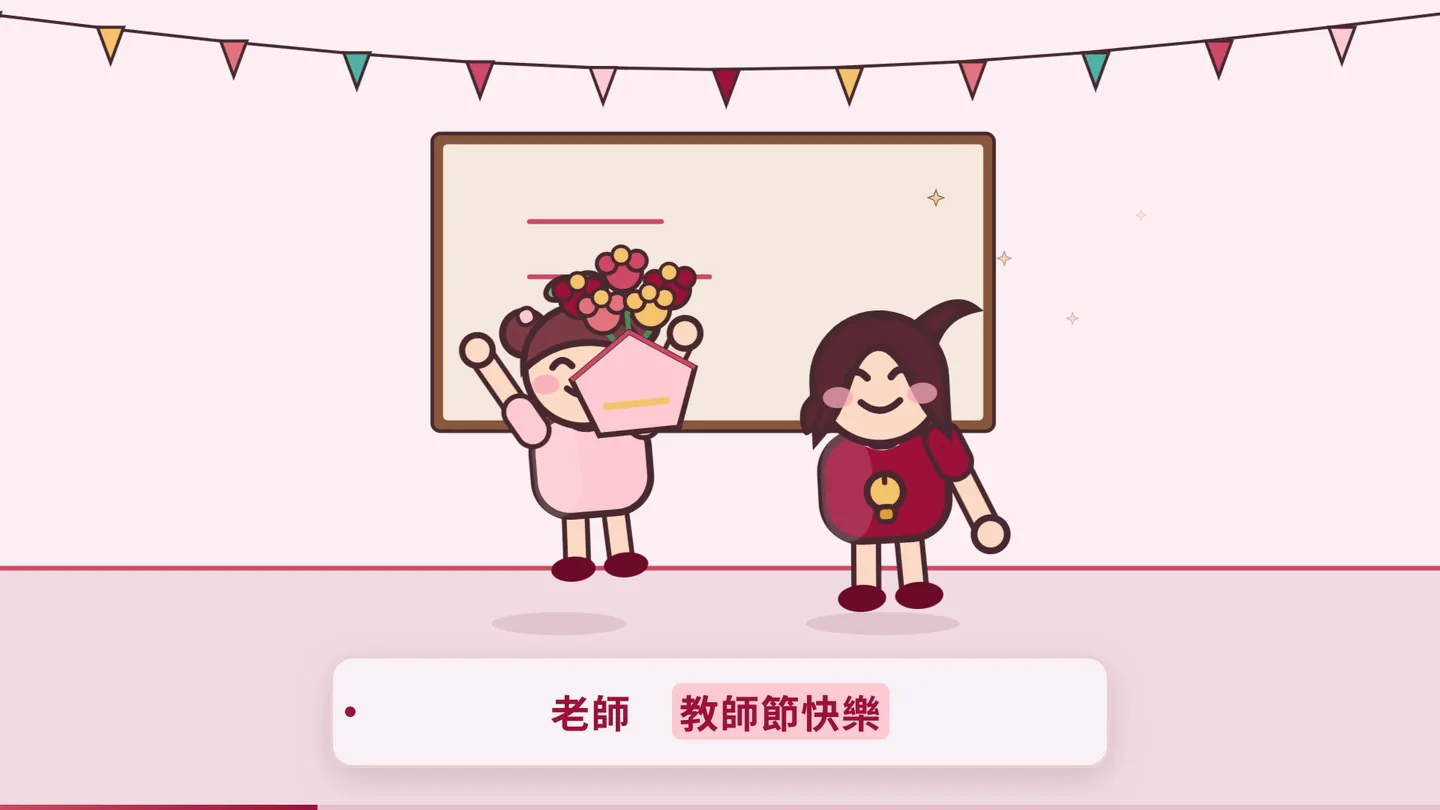 修好後的字幕在人物下方(t=45s)
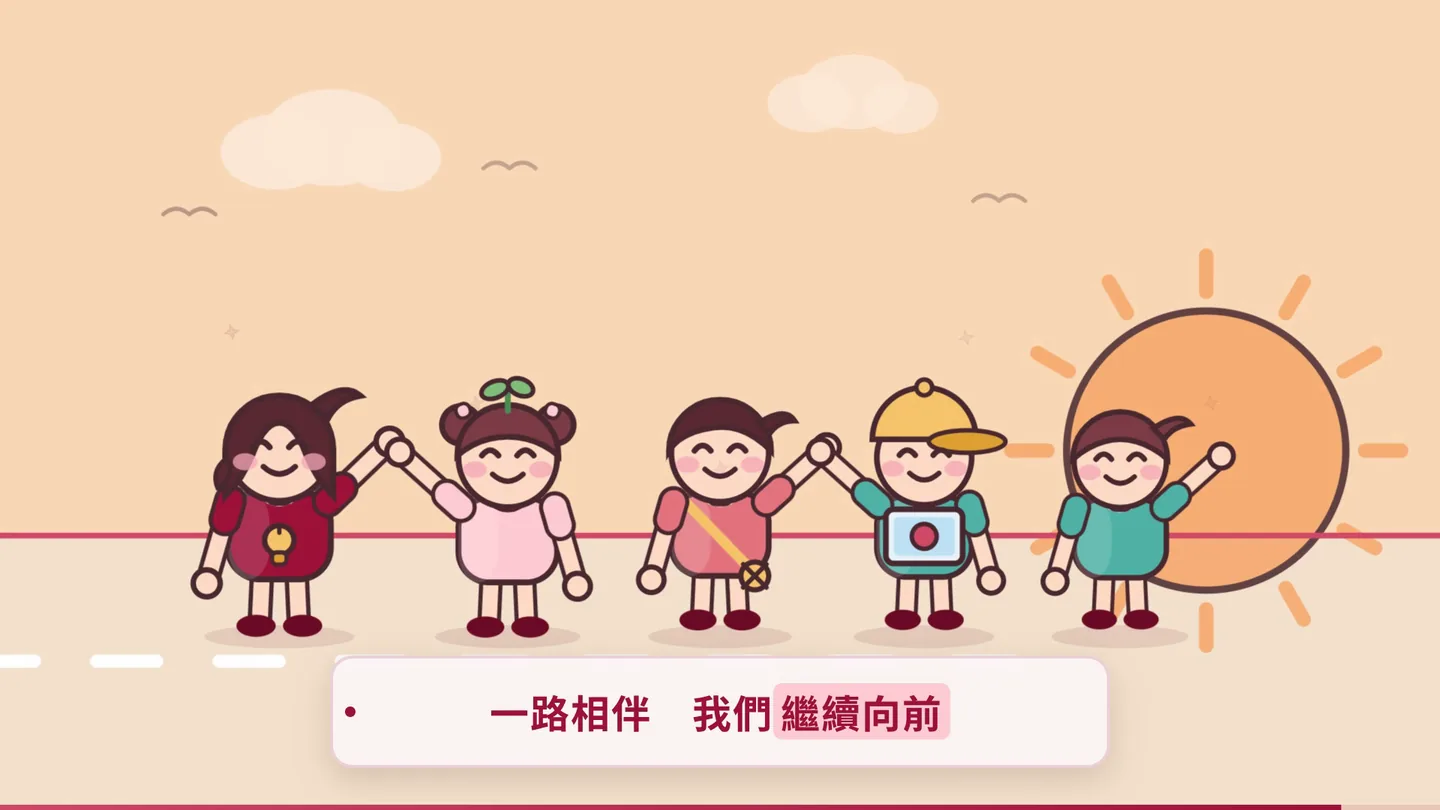 結尾的全體畫面(t=190s)
0518:37–21:46
同一支歌,長出 15 秒的版本
他問能不能再做一段放 Facebook Reel 的限動。Irene 先出 15 秒直立試片 —— 選 43.7–58.7 秒那段副歌,理由寫了三條 —— 他點頭才做 30 秒版。一天之內,一首歌變成三個長度。
「可以產生一段適合放 Facebook Reel 的限動短影片嗎?」
Jason · 18:37
「試片做完了,五項驗收全部有數字。」
Irene · 19:41